13 oct 2026
4 min de lectura
- Open Source
- NestJS
- TypeORM
- MikroORM
- Angular
- Electron
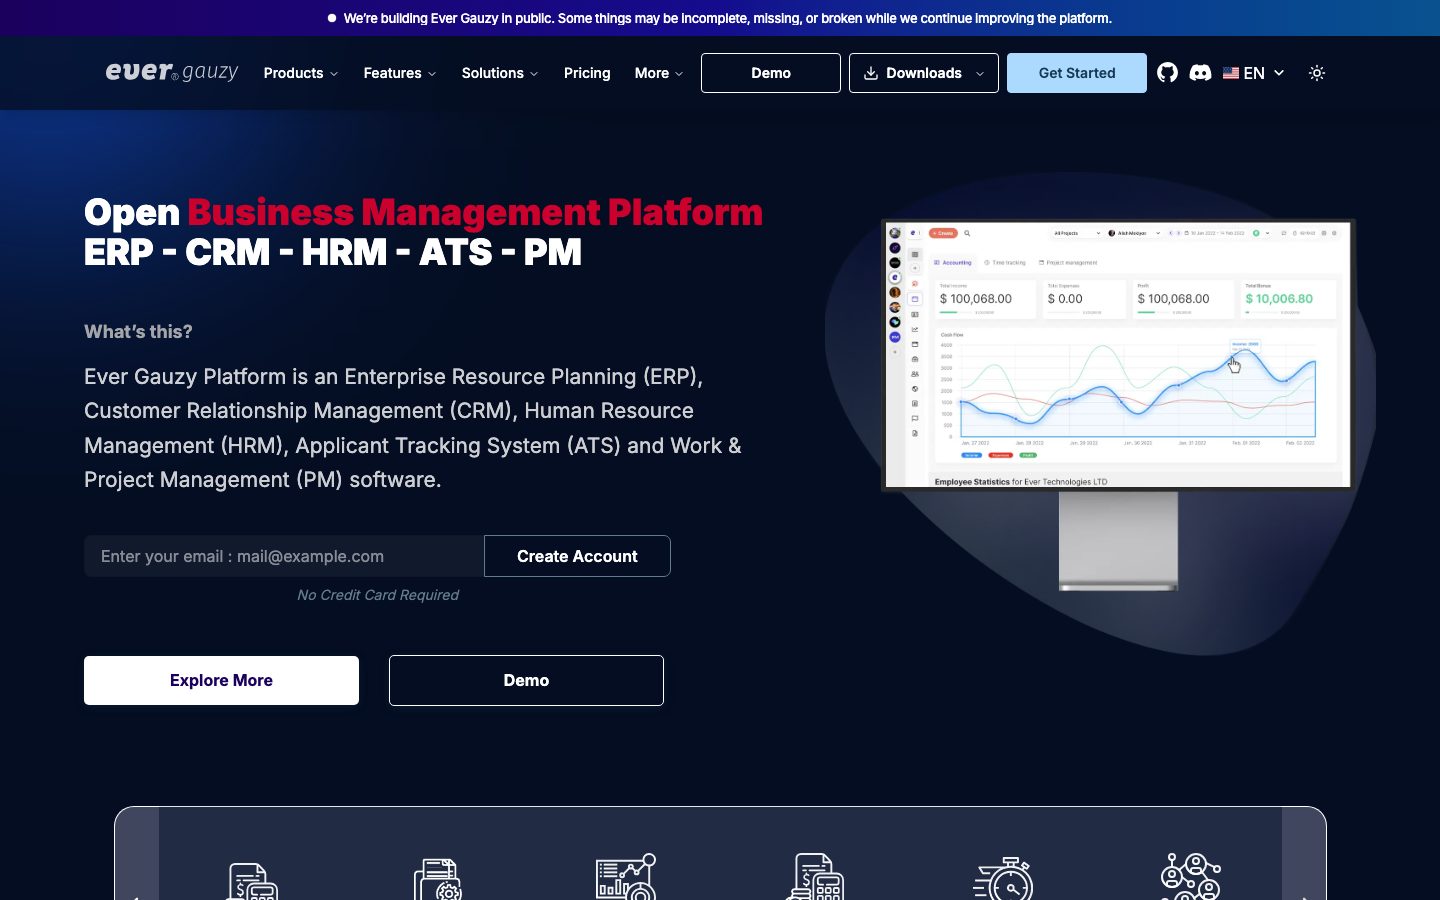
Ever Gauzy es un software gratuito que gestiona toda una empresa — RR. HH., clientes, proyectos, horas y facturas — en un solo lugar. Qué lo hace distinto, mis 53 mejoras y lo que aprendí.
El proyecto
En una frase: Ever Gauzy es un software gratuito para gestionar una empresa — empleados, clientes, proyectos, horas trabajadas, facturas y gastos — en un solo lugar.
Imagina una agencia de 30 personas. Hoy probablemente paga una herramienta para registrar horas, otra para las facturas, otra para las vacaciones y RR. HH., y una hoja de cálculo para las ventas. Ninguna habla con las demás, así que alguien copia datos entre ellas cada semana. Gauzy sustituye ese montón por una sola aplicación: el empleado que registra horas en un proyecto es el mismo que aparece en la factura del cliente y en el calendario de vacaciones.
Es open source: una empresa puede usarlo gratis e instalarlo en sus propios servidores, manteniendo sus datos en casa. También hay una versión web, una demo y aplicaciones de escritorio para Windows, macOS y Linux.
Qué lo hace innovador
- Todo en un solo lugar, y gratis. Las suites que lo hacen todo suelen atar a las empresas y cobrar por usuario. Gauzy ofrece el mismo abanico — RR. HH., ventas, proyectos, horas, facturas — como un software que la empresa posee.
- Se acabó copiar datos entre herramientas. Como todas las partes comparten las mismas personas, clientes y proyectos, una pregunta como «¿cuánto nos ha costado este proyecto?» se responde con un clic.
- Pensado para el trabajo en remoto. Una aplicación de escritorio registra el tiempo de trabajo: responsables y clientes ven las horas reales, no estimaciones.
- Crece con la empresa. Varias compañías, oficinas, monedas e idiomas pueden convivir en una sola instalación, y las extensiones lo amplían — incluso para que asistentes de IA trabajen con él.
En resumen: mi contribución y lo que aprendí
Mi parte: corregí 53 problemas en Gauzy, todos aceptados por los mantenedores. La mayoría eran casos en los que el software daba respuestas distintas, o erróneas, según cómo estuviera instalado — facturas borradas que seguían contando en las estadísticas, horas contadas varias veces, citas mostradas 12 horas tarde. Uno afectaba a la privacidad: cualquier empleado podía leer las notificaciones de todos sus compañeros. También arreglé las capturas de pantalla en ordenadores con varias pantallas.
Lo que me llevo: cuando un producto promete funcionar «en todas partes», hay que probar cada variante — los bugs se esconden en la versión que nadie usa a diario. Y las mejoras pequeñas y concretas se aceptan mucho más rápido que las grandes.
El resto del artículo entra en los detalles técnicos, para desarrolladores.
Por dentro
Un gran monorepo Nx (más de 8 000 estrellas en GitHub, AGPL-3.0) — API NestJS, app web Angular, apps de escritorio Electron, unos 80 plugins, PostgreSQL / MySQL / SQLite.
En detalle: lo que aporté
Mi contribución en cifras: 53 pull requests, todas fusionadas (+5,9k / −1,1k líneas), casi todas con specs de Jest.
Paridad TypeORM / MikroORM
Una veintena de PR salen de un mismo ejercicio: tomar una funcionalidad, leer las dos ramas y encontrar dónde MikroORM dice otra cosa.
- Los operadores desconocidos lo devolvían todo.
LessThan,LessThanOrEqual,LikeeILikese traducían a{}, que MikroORM interpreta como ninguna condición. Un filtro de «importe máximo» en las facturas devolvía todas las facturas. Añadí las traducciones que faltaban. ILIKEen MySQL y SQLite. MikroORM emite$iliketal cual, y esas bases lo rechazan. AñadíisMikroOrmPostgres()(la comprobación existente siempre respondía «postgres» con MikroORM) y dos helpers,mikroOrmContainsymikroOrmILike, que ahora usa la búsqueda de tareas, etiquetas, empleados y candidatos.- Datos borrados que se filtraban por Knex. Knex en bruto se salta el filtro de borrado lógico de MikroORM: el endpoint público
/stats/globalcontaba facturas borradas y los informes de presupuesto, tiempo borrado. Cada lectura tiene ahora suwhereNull('deletedAt').
Permisos en una aplicación multi-tenant
La corrección más importante es #10495. El servicio base filtra las consultas por employeeId, pero las notificaciones usan receiverEmployeeId, así que cualquier empleado podía leer todas las notificaciones del tenant. Añadí un alcance por destinatario a cada lectura, incluida cada rama de una condición OR. En la misma zona, las menciones llegan por fin a la persona mencionada, y quitar a un miembro de un equipo lo quita de verdad.
Cifras que estaban mal
- Una hora dividida en seis franjas contaba como 6 horas (el join la multiplicaba).
- El uso de las etiquetas se inflaba con 25
LEFT JOIN; corregido conCOUNT(DISTINCT …). 'YYYY-MM-DD hh:mm:ss'sin AM/PM desplazaba las horas 12 h en tres sitios: las citas de la tarde aparecían a las 2 de la madrugada.
Ordenación, búsqueda y temporizador de escritorio
Un parseSortOrder() con lista blanca para que las tablas ordenen de verdad, splitKeywords() para que un espacio de más ya no devuelva todas las filas y, en el temporizador Electron, capturas con varias pantallas que elegían la pantalla equivocada (solo se comparaba la x del cursor) o no capturaban nada en algunas configuraciones de Linux.
Lecciones técnicas
- Una abstracción falla justo donde nadie prueba. Soportar dos ORM es prometer que ambos responden igual a la misma pregunta. Los bugs vivían en la rama que nadie ejecutaba en local. Desde entonces pruebo la rama, no solo la funcionalidad.
- Las consultas en bruto se saltan las redes de seguridad. Los filtros globales (borrado lógico, alcance del tenant) solo protegen el código que pasa por el ORM. Cada
knex(...)es un sitio donde hay que volver a aplicarlos a mano. - Los filtros de permisos dependen de los nombres. Un filtro automático basado en
employeeIdignora en silencio una tabla que llama a lo mismoreceiverEmployeeId. La seguridad que depende de convenciones necesita un test por cada excepción. - Un helper vale más que ocho correcciones.
splitKeywords()arregló ocho sitios de una vez y mantiene correcto el siguiente. - Las PR pequeñas y acotadas se fusionan. 53 PR concretas avanzaron más rápido de lo que lo habrían hecho unas pocas grandes.