13 oct. 2026
4 min de lecture
- Open Source
- NestJS
- TypeORM
- MikroORM
- Angular
- Electron
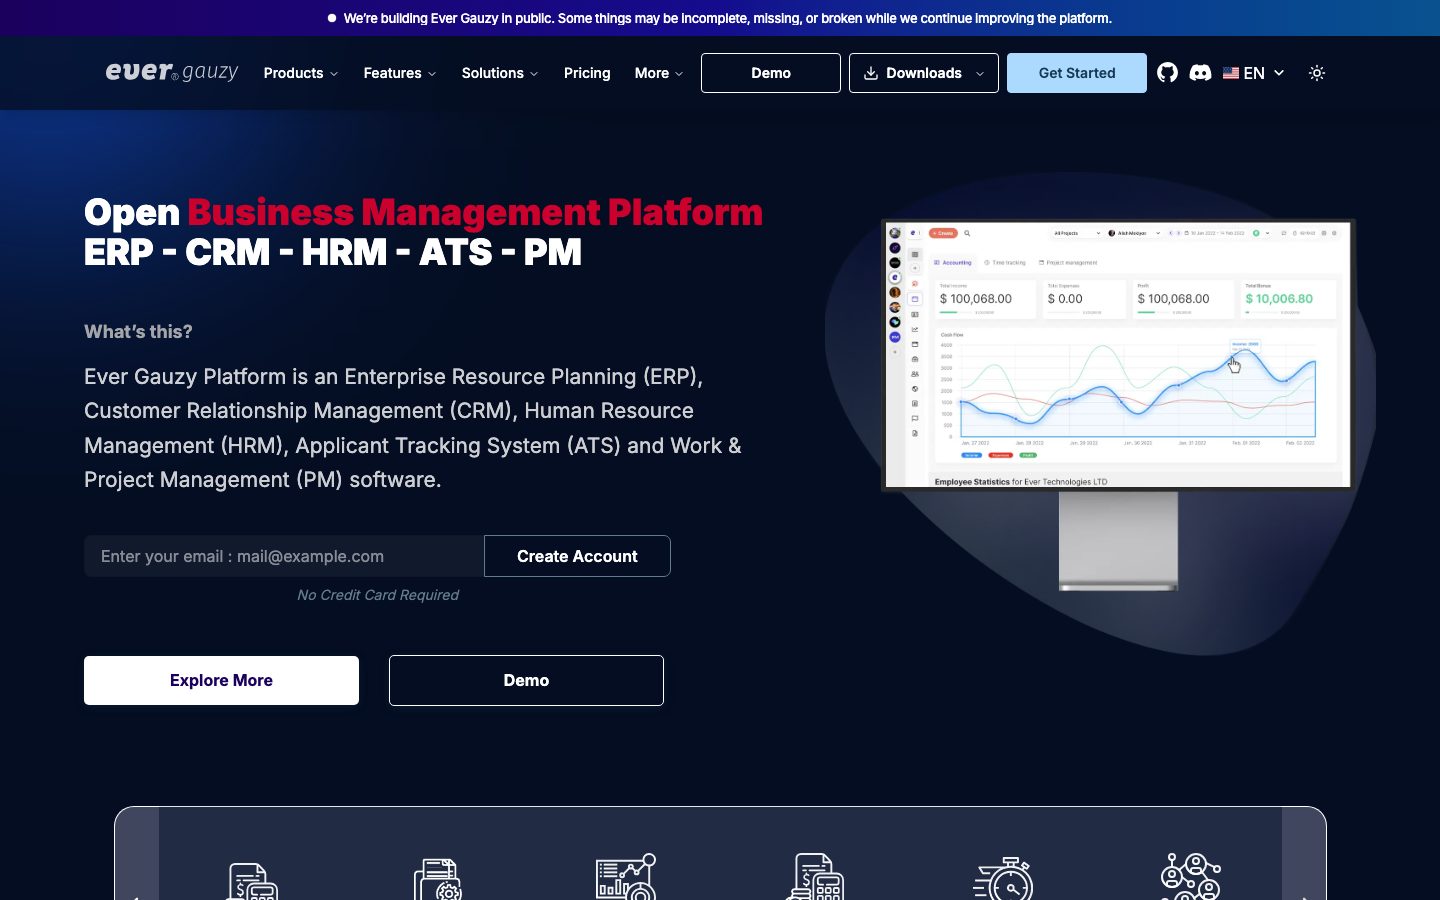
Ever Gauzy est un logiciel gratuit qui gère toute une entreprise — RH, clients, projets, heures et factures — au même endroit. Ce qui le rend différent, mes 53 améliorations, et ce que j'en ai appris.
Le projet
En une phrase : Ever Gauzy est un logiciel gratuit pour gérer une entreprise — employés, clients, projets, heures travaillées, factures et dépenses — au même endroit.
Imaginez une agence de 30 personnes. Aujourd'hui, elle paie sans doute un outil pour suivre les heures, un autre pour les factures, un autre pour les congés et les RH, et un tableur pour les ventes. Aucun ne communique avec les autres, alors quelqu'un recopie les données chaque semaine. Gauzy remplace cet empilement par une seule application : l'employé qui enregistre ses heures sur un projet est le même qui apparaît sur la facture du client et dans le calendrier des congés.
C'est un logiciel open source : une entreprise peut l'utiliser gratuitement et l'installer sur ses propres serveurs, en gardant ses données chez elle. Il existe aussi une version web, une démo, et des applications desktop pour Windows, macOS et Linux.
Ce qui le rend innovant
- Tout au même endroit, et gratuit. Les suites qui font tout enferment souvent les entreprises et facturent par utilisateur. Gauzy offre le même éventail — RH, ventes, projets, heures, factures — sous forme d'un logiciel qu'une entreprise possède.
- Fini de recopier les données d'un outil à l'autre. Comme toutes les parties partagent les mêmes personnes, clients et projets, une question comme « combien ce projet nous a-t-il coûté ? » se règle en un clic.
- Pensé pour le travail à distance. Une application sur ordinateur enregistre le temps de travail : managers et clients voient les vraies heures, pas des estimations.
- Grandit avec l'entreprise. Plusieurs sociétés, bureaux, devises et langues peuvent cohabiter dans une seule installation, et des extensions l'enrichissent — y compris pour que des assistants IA puissent travailler avec.
En bref : ma contribution et ce que j'en retiens
Ma part : j'ai corrigé 53 problèmes dans Gauzy, tous acceptés par les mainteneurs. La plupart étaient des cas où le logiciel donnait des réponses différentes, ou fausses, selon la façon dont il était installé — des factures supprimées encore comptées dans les statistiques, des heures comptées plusieurs fois, des rendez-vous affichés 12 heures trop tard. L'un touchait à la vie privée : n'importe quel employé pouvait lire les notifications de tous ses collègues. J'ai aussi corrigé les captures d'écran sur les ordinateurs à plusieurs écrans.
Ce que j'en retiens : quand un produit promet de fonctionner « partout », chaque variante doit être testée — les bugs se cachent dans la version que personne n'utilise au quotidien. Et de petites améliorations ciblées sont acceptées bien plus vite que de grosses.
La suite de l'article entre dans les détails techniques, pour les développeurs.
Sous le capot
Un grand monorepo Nx (8 000+ étoiles GitHub, AGPL-3.0) — API NestJS, app web Angular, apps desktop Electron, environ 80 plugins, PostgreSQL / MySQL / SQLite.
En détail : ce que j'ai apporté
Ma contribution en chiffres : 53 pull requests, toutes mergées (+5,9k / −1,1k lignes), presque toutes avec des specs Jest.
La parité TypeORM / MikroORM
Une vingtaine de PR viennent d'un même exercice : prendre une fonctionnalité, lire les deux branches, trouver où MikroORM dit autre chose.
- Les opérateurs inconnus matchaient tout.
LessThan,LessThanOrEqual,LikeetILikeétaient traduits en{}, ce que MikroORM lit comme aucune condition. Un filtre « montant maximum » sur les factures renvoyait toutes les factures. J'ai ajouté les traductions manquantes. ILIKEsur MySQL et SQLite. MikroORM émet$iliketel quel, ce que ces bases refusent. J'ai ajoutéisMikroOrmPostgres()(la vérification existante répondait toujours « postgres » sous MikroORM) et deux helpers,mikroOrmContainsetmikroOrmILike, utilisés maintenant par la recherche des tâches, tags, employés et candidats.- Des données supprimées qui fuyaient par Knex. Knex brut contourne le filtre de suppression logique de MikroORM : le
/stats/globalpublic comptait des factures supprimées, les rapports de budget du temps supprimé. Chaque lecture a maintenant sonwhereNull('deletedAt').
Les permissions dans une application multi-tenant
La correction la plus importante est #10495. Le service de base filtre les requêtes par employeeId, mais les notifications utilisent receiverEmployeeId — donc n'importe quel employé pouvait lire toutes les notifications du tenant. J'ai ajouté un périmètre « destinataire » à chaque lecture, y compris dans chaque branche d'une condition OR. Dans la même zone, les mentions arrivent enfin à la personne mentionnée, et retirer un membre d'une équipe le retire vraiment.
Des chiffres faux
- Une heure découpée en six créneaux comptait pour 6 heures (la jointure la multipliait).
- L'usage des tags était gonflé par 25
LEFT JOIN; corrigé avecCOUNT(DISTINCT …). 'YYYY-MM-DD hh:mm:ss'sans AM/PM décalait les heures de 12 h à trois endroits — les rendez-vous de l'après-midi s'affichaient à 2 h du matin.
Tri, recherche et timer desktop
Un parseSortOrder() en liste blanche pour que les tableaux trient vraiment, splitKeywords() pour qu'un espace en trop ne renvoie plus toutes les lignes, et dans le timer Electron, des captures multi-écrans qui choisissaient le mauvais écran (seul le x du curseur était comparé) ou ne capturaient rien sur certaines configs Linux.
Les leçons techniques
- Une abstraction fuit exactement là où personne ne teste. Supporter deux ORM, c'est promettre que les deux répondent pareil à la même question. Les bugs vivaient dans la branche que personne ne lançait en local. Depuis, je teste la branche, pas seulement la fonctionnalité.
- Les requêtes brutes contournent les filets de sécurité. Les filtres globaux (suppression logique, périmètre du tenant) ne protègent que le code qui passe par l'ORM. Chaque
knex(...)est un endroit où il faut les réappliquer à la main. - Les filtres de permission dépendent du nommage. Un filtre automatique basé sur
employeeIdignore en silence une table qui appelle la même chosereceiverEmployeeId. Une sécurité qui repose sur des conventions a besoin d'un test par exception. - Un helper vaut mieux que huit correctifs.
splitKeywords()a corrigé huit endroits d'un coup et garde le prochain correct. - Les petites PR ciblées sont mergées. 53 PR précises ont avancé plus vite que quelques grosses.