13 oct. 2026
5 min de lecture
- Open Source
- Python
- FastAPI
- Security
- React
- AI
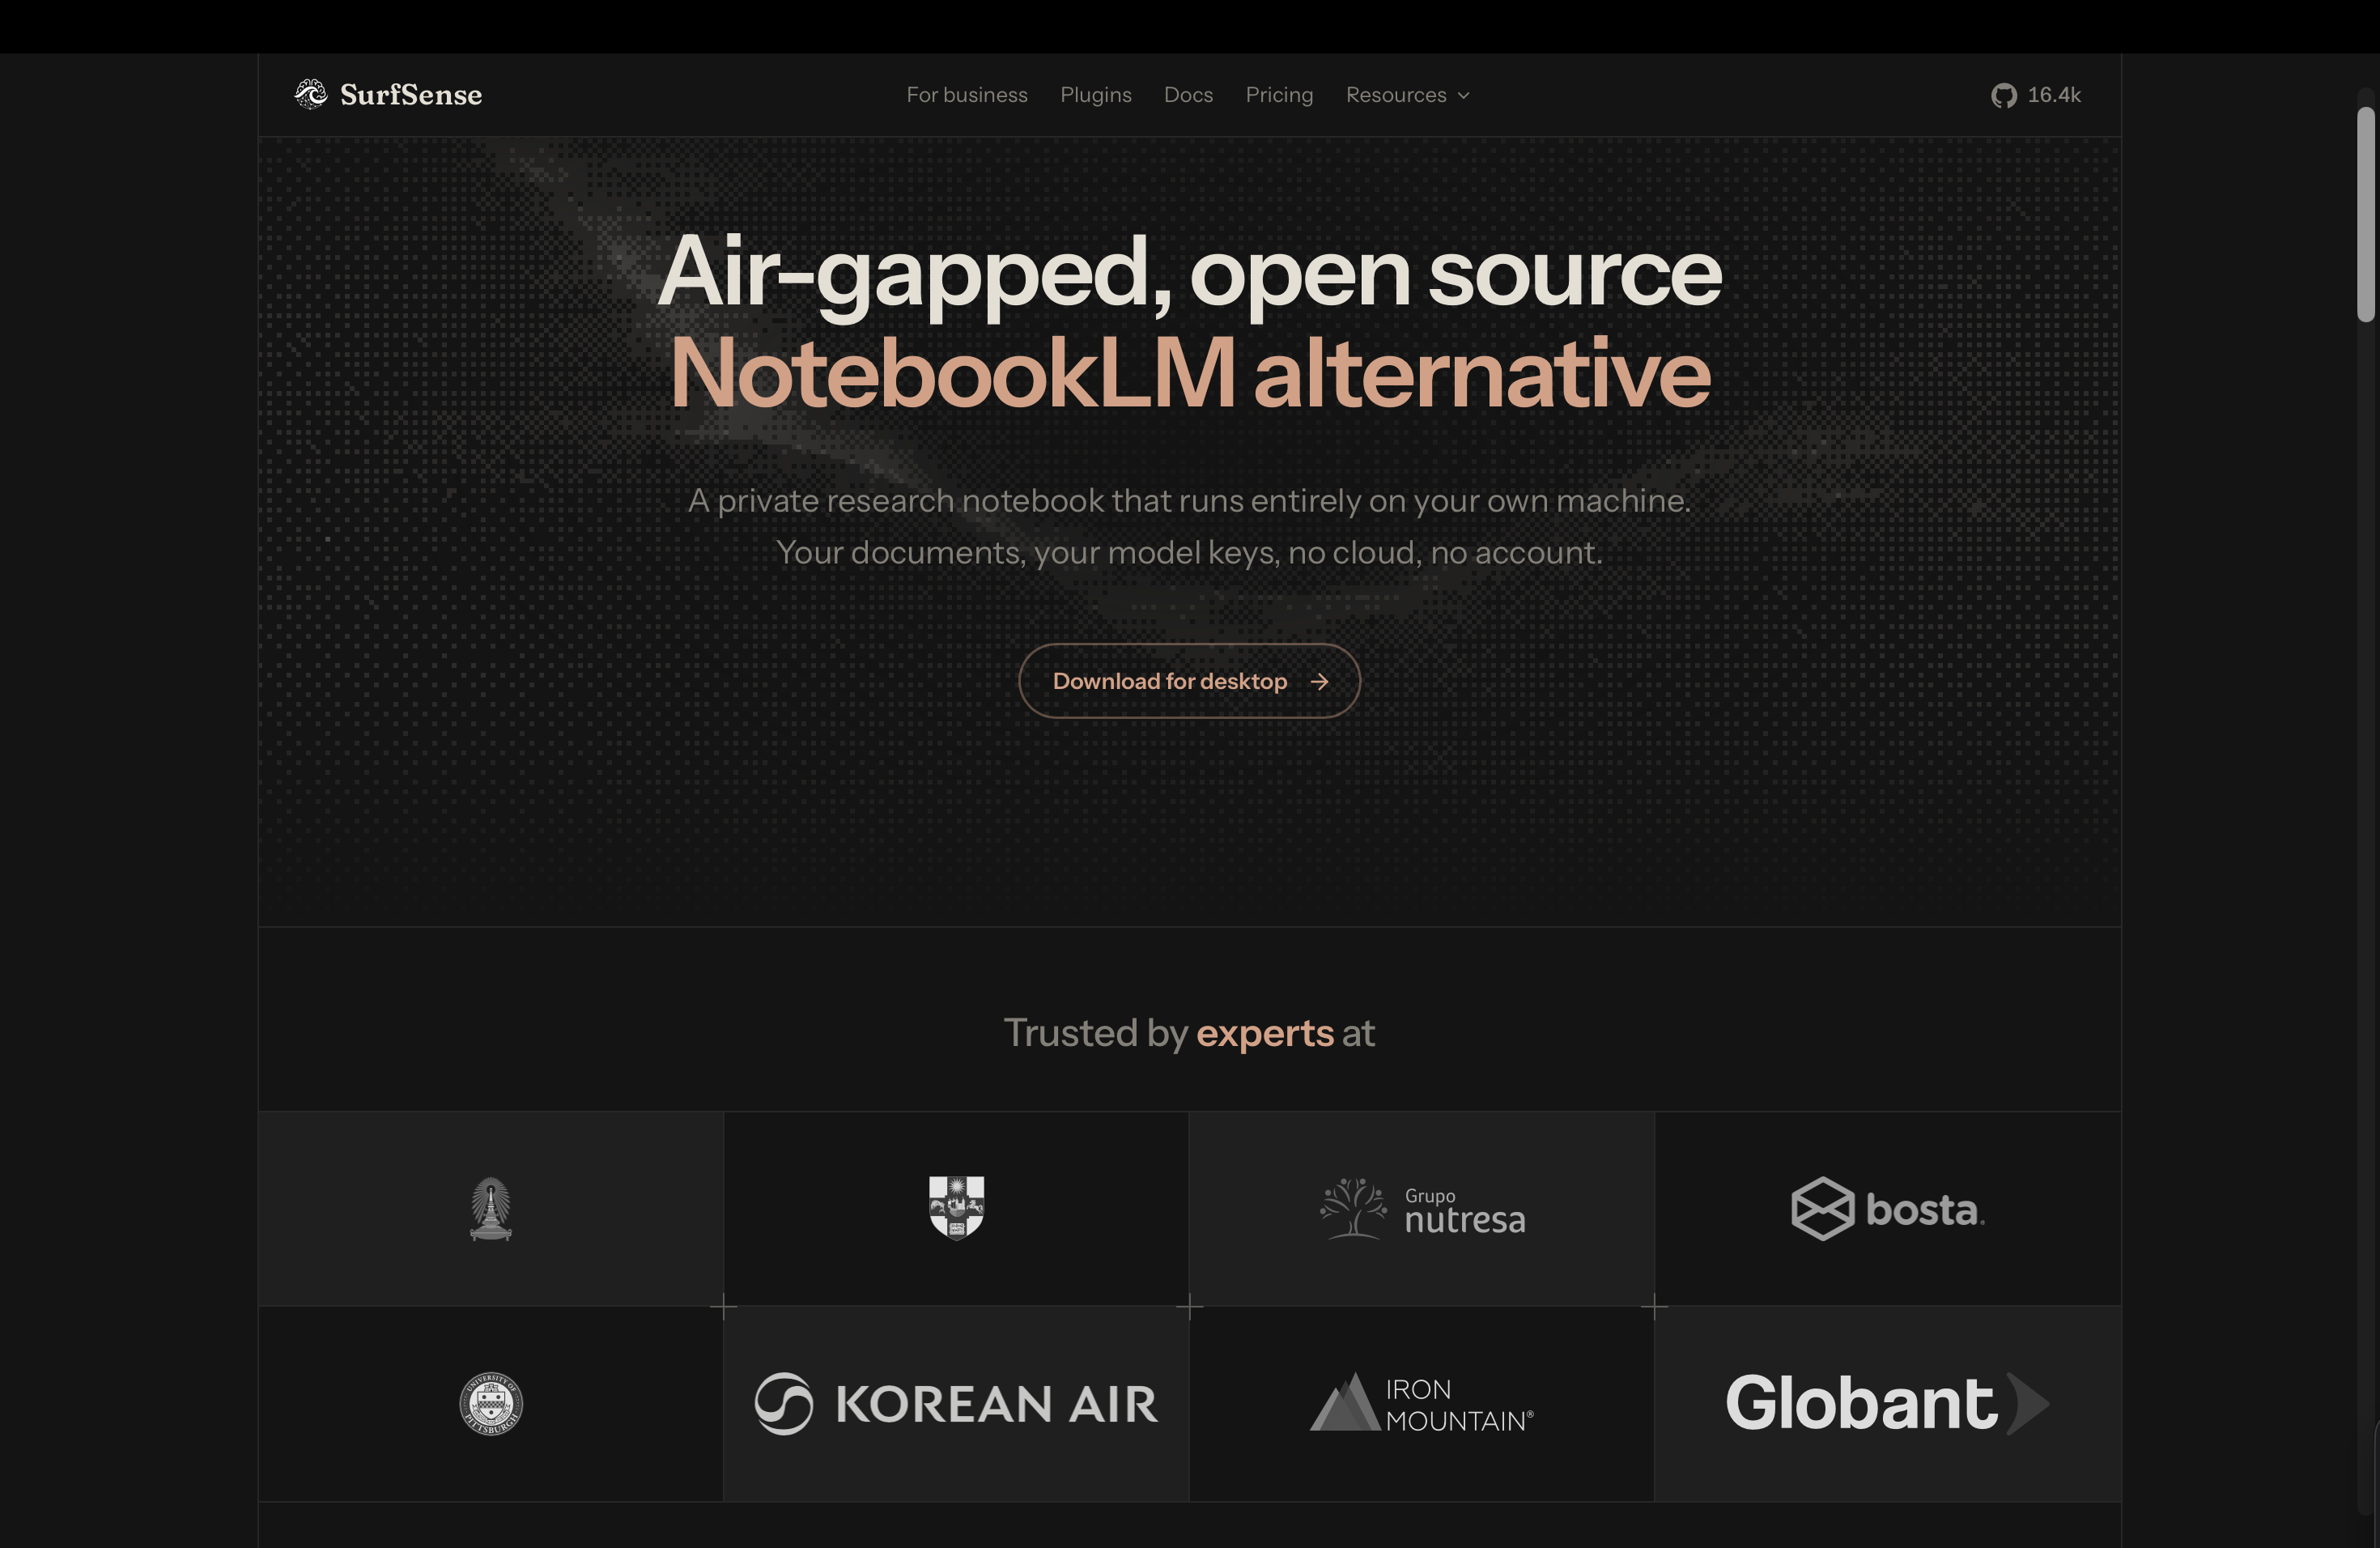
SurfSense permet de poser des questions à ses documents et d'obtenir des réponses sourcées — sans que rien ne quitte votre ordinateur. Pourquoi c'est important, comment j'ai aidé à le sécuriser, et ce que j'ai appris.
Le projet
En une phrase : SurfSense est une application desktop gratuite qui permet de « discuter » avec ses documents — leur poser des questions, obtenir des réponses avec leurs sources, et les transformer en nouveaux fichiers — sans que rien ne quitte votre ordinateur.
Vous avez sans doute déjà vu ces outils où l'on envoie des PDF pour demander à une IA « que dit ce contrat sur la résiliation ? ». Ils sont utiles, mais vos fichiers partent sur les serveurs de quelqu'un d'autre. Pour un avocat, un médecin, un chercheur ou une entreprise avec des rapports internes, c'est souvent interdit. SurfSense offre la même expérience en gardant tout sur votre machine : pas de compte, pas d'envoi.
Il lit les PDF, Word, Excel, PowerPoint, images (avec reconnaissance de texte) et plus ; il répond avec des citations qui renvoient au passage exact ; et il peut écrire de nouveaux documents, présentations ou tableurs, ou transformer vos sources en podcast, carte mentale, fiches de révision ou quiz. Il tourne sur Windows, macOS et Linux et compte plus de 16 000 étoiles sur GitHub.
Ce qui le rend innovant
- L'IA travaille sur votre propre ordinateur. Vos questions et vos documents sont traités en local. On peut toujours brancher un service d'IA en ligne — mais c'est votre choix.
- Rien d'autre à installer que l'app. Pas de serveur, pas de compte : votre bibliothèque tient dans un seul fichier sur votre disque.
- Privé par défaut. L'application ne contacte aucun site tant que vous ne l'avez pas décidé, et n'envoie aucune donnée d'usage.
- Il crée, il ne fait pas que répondre. Il peut écrire de nouveaux documents, présentations ou tableurs à partir de vos sources — toujours en nouveaux fichiers, sans jamais écraser les vôtres.
En bref : ma contribution et ce que j'en retiens
Ma part : 25 de mes 28 améliorations ont été acceptées. Les plus importantes protègent les utilisateurs : l'IA écrit de petits programmes pour fabriquer des présentations et des tableurs, et j'ai fait en sorte que ces programmes tournent enfermés dans une boîte où ils ne voient aucun mot de passe et ne peuvent pas tourner indéfiniment. J'ai aussi fait en sorte que l'app demande avant de contacter un site jamais autorisé, corrigé un cas où renommer un document pouvait être annulé en silence, et amélioré l'accessibilité pour les personnes qui utilisent un lecteur d'écran.
Ce que j'en retiens : tout ce qu'une IA produit après avoir lu des documents doit être traité avec la même prudence qu'un fichier inconnu. Et la règle de sécurité la plus sûre est celle que le logiciel rend impossible à oublier.
La suite de l'article entre dans les détails techniques, pour les développeurs.
Sous le capot
Electron qui supervise une API FastAPI locale, des files de jobs Huey, llama.cpp, stable-diffusion.cpp et audio.cpp pour les modèles, et un seul fichier SQLite avec FTS5 et sqlite-vec pour la recherche.
En détail : ce que j'ai apporté
Ma contribution en chiffres : 28 pull requests, 25 mergées (+5,3k / −0,7k lignes), sur le backend Python, le frontend React et le portail de licences.
Le code écrit par le modèle sort de exec()
#2184 est celle dont je suis le plus fier. Le générateur PowerPoint et Excel de Studio exécutait avec exec() du Python écrit par un LLM qui venait de lire les documents non fiables de l'utilisateur, dans le worker, avec ses privilèges — et le timeout ne pouvait pas arrêter un thread emballé.
Je l'ai fait passer par le lanceur de scripts que Word et PDF utilisaient déjà : son propre processus, un dossier vide, un seul chemin de sortie, un environnement reconstruit sans secrets. En cas de timeout ou d'annulation, tout l'arbre de processus est tué (job object sous Windows, groupe de processus ailleurs). Les tests lancent de vrais processus enfants pour prouver qu'un faux secret est invisible pour le script et qu'une boucle infinie meurt à une limite d'une seconde. Le verdict du mainteneur : « c'est strictement plus sûr ».
Le consentement réseau pour des hôtes qu'on n'a pas choisis
Un service d'images distant peut répondre avec une URL sur un CDN quelconque, et SurfSense la téléchargeait — envoyant l'IP de l'utilisateur vers un hôte qu'il n'avait jamais autorisé. Dans #2072, le fournisseur d'images prend un callback allow_url_host obligatoire, attendu avant tout téléchargement : aucun futur appel ne peut l'oublier. Les hôtes refusés apparaissent dans Réglages › Réseau.
Une course entre le worker et l'utilisateur
Renommer un fichier pendant son import annulait silencieusement le nouveau nom : le worker gardait une vieille copie de la ligne et réécrivait tout. La correction (#2148) n'écrit que les colonnes produites par le job :
update(Document)
  .where(Document.id == doc_id, Document.status != CANCELLED)
  .values(status=..., error_message=..., **produced)
Un test qui a trouvé un bug
Le transport ASGI en mémoire ne sait pas simuler un client qui raccroche. J'ai ajouté une fixture qui sert l'app sur un vrai socket et un faux serveur de modèle qui se bloque — et elle a révélé que Starlette annule l'enregistrement d'une réponse partielle à la déconnexion. Je l'ai signalé et épinglé avec un xfail strict ; il a été corrigé le lendemain.
Aussi : les réglages d'échantillonnage recommandés pour chaque modèle, Anthropic avec une simple clé d'API, la révocation des tokens ChatGPT à la déconnexion, des remboursements Stripe qui suspendaient toutes les licences d'un client, une annonce pour lecteur d'écran quand une réponse se termine, et l'état de Studio déplacé dans TanStack Query.
Les leçons techniques
- Traiter la sortie d'un LLM comme une entrée non fiable. Du code écrit par un modèle après avoir lu des documents utilisateur est aussi dangereux que ces documents. Sa place est dans un bac à sable, pas dans
exec(). - Faire du chemin sûr le seul chemin. Un callback obligatoire dans la signature d'une fonction vaut mieux qu'une règle d'équipe : c'est le compilateur, pas le relecteur, qui attrape le prochain appel qui l'oublie.
- Corriger à la cause. Le bug du renommage aurait pu être rustiné dans l'interface. N'écrire que les colonnes qui appartiennent au job a corrigé toute la famille des mises à jour perdues.
- Des tests réalistes trouvent de vrais bugs. Un vrai socket a révélé ce qu'aucun test en mémoire ne pouvait voir. Quand un scénario semble intestable, construire le harnais rapporte souvent deux fois.
- Une équipe pilotée par la doc est facile à rejoindre. Les docs d'architecture et la liste des « manques connus » m'ont dit par où commencer et ce que « terminé » voulait dire. Les revues étaient exigeantes, et chacune a amélioré la correction.